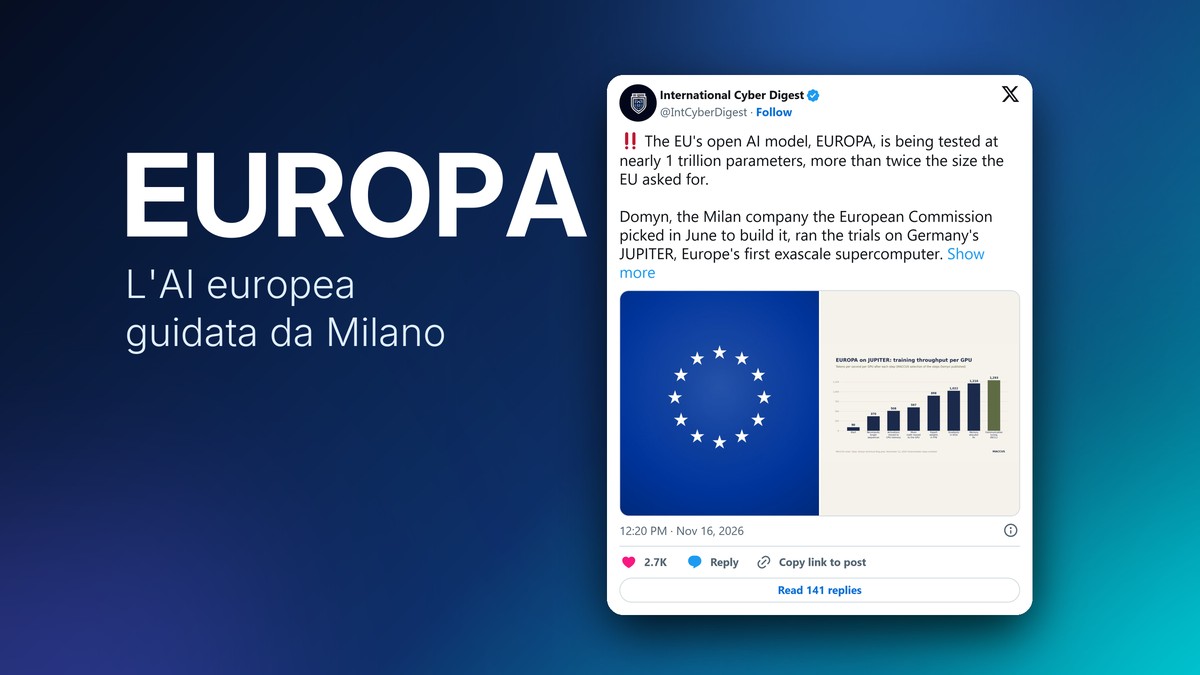
Il modello di intelligenza artificiale “pubblico” dell’Unione europea si chiama EUROPA e lo sta costruendo un’azienda di Milano, Domyn (la ex iGenius). Nelle prove sul supercomputer tedesco JUPITER è arrivato a 951,9 miliardi di parametri, più del doppio del minimo chiesto da Bruxelles. Lo ha rilanciato un post di @IntCyberDigest, arrivato a 368.000 visualizzazioni e 2.700 like al 18 novembre.
Cos’è EUROPA e perché c’entra l’Italia
A giugno 2026 la Commissione europea ha assegnato la Frontier AI Grand Challenge al consorzio EUROPA, guidato da Domyn insieme a due istituti tedeschi Fraunhofer (IAIS e IIS). L’obiettivo, come riporta Smartworld, è un modello open source di uso generale che parli tutte le 24 lingue ufficiali dell’UE, italiano compreso.
Il premio non è un assegno: è l’accesso fino al 2,5% della potenza di calcolo della rete europea EuroHPC per un anno. Il bando chiedeva un modello da oltre 400 miliardi di parametri.
Domyn non parte da zero: è nata a Milano nel 2016 e ha già pubblicato Domyn Large, un modello da 260 miliardi di parametri disponibile su Microsoft Foundry.
Cosa vuol dire “951 miliardi, ma 32,8 attivi”
EUROPA usa un’architettura mixture of experts, la stessa di DeepSeek e di Kimi K3.1: dentro ci sono 384 “esperti” e per ogni parola ne lavorano solo 8. Così, su 951,9 miliardi di parametri totali, a ogni passo se ne usano circa 32,8 miliardi, cioè il 3,4%. Il modello sa molto, ma costa meno farlo girare.
Le prove descritte da Domyn in un post tecnico del 12 novembre (ripreso anche dal blog di PyTorch) riguardano soprattutto la velocità di addestramento:
- da circa 90 a circa 1.300 token al secondo per GPU, circa 14 volte più veloce;
- 384 chip NVIDIA GH200 su 96 nodi di JUPITER, il primo supercomputer europeo di classe exascale;
- con 4 copie in parallelo su 1.536 GPU, circa il 6% di JUPITER.
Sono misure interne e brevi, senza verifiche indipendenti, e Domyn avverte che alcuni valori possono cambiare prima dell’addestramento vero.
Quando si potrà usare
Per ora non c’è niente da scaricare né da provare: i pesi non sono pubblici e non sono stati annunciati licenza, dati di addestramento e data di uscita. A giugno il CEO Uljan Sharka ha detto a Reuters che il modello sarebbe stato pronto entro un anno, quindi verso giugno 2027. Secondo il Quotidiano Nazionale il solo pre-addestramento dovrebbe durare circa quattro mesi.
Non ci sono ancora test di qualità, quindi è presto per dire se EUROPA potrà competere con i modelli che usi oggi. Le dimensioni da sole non bastano: DeepSeek-V3 aveva già 671 miliardi di parametri nel 2024 e Kimi K3.1 arriva a 2,8 trilioni.
Perché è una notizia anche per chi usa l’AI in Italia
Un modello aperto, europeo e in italiano potrebbe girare su server di aziende e pubbliche amministrazioni senza mandare i dati fuori dall’UE. È lo stesso problema per cui DeepSeek in Italia è stato limitato: con un modello aperto si può usare in locale, come già succede con Qwen sulla propria scheda video.
Nel frattempo, se vuoi capire quale assistente usare oggi, parti dalla nostra guida all’intelligenza artificiale e dal confronto sulla migliore intelligenza artificiale del 2026.
Fonte: post di @IntCyberDigest su X, Reuters, Smartworld, Quotidiano Nazionale.