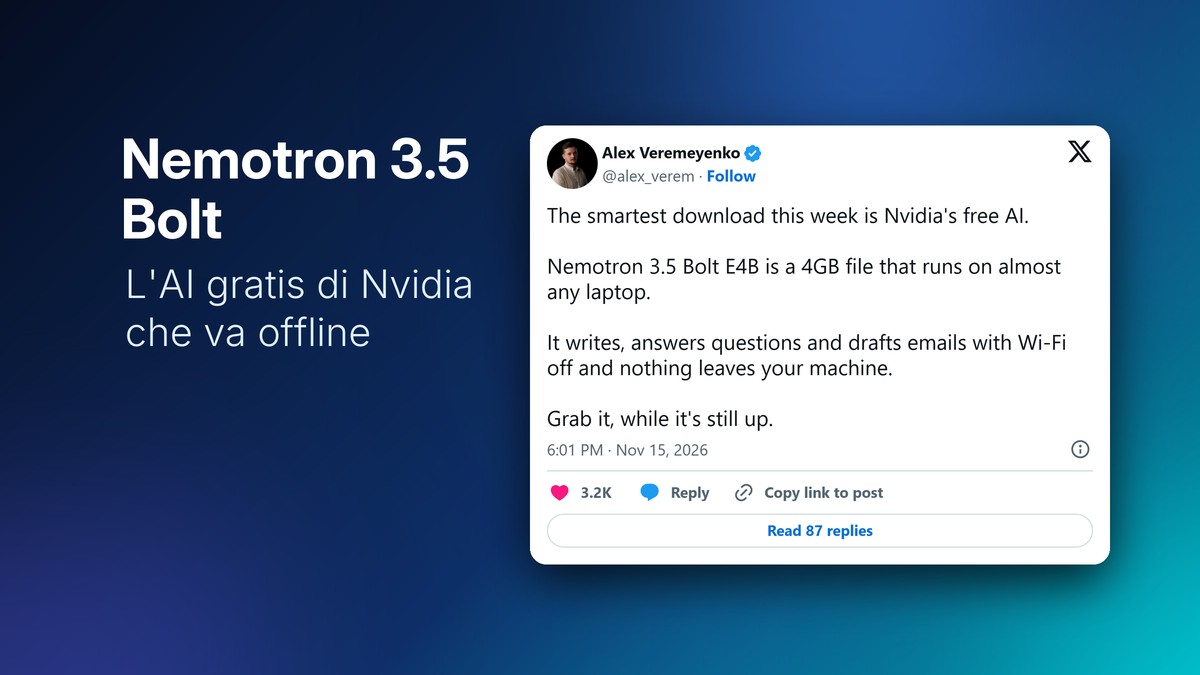
Un’intelligenza artificiale che scrive, risponde e prepara email con il Wi-Fi spento, senza mandare niente su internet: è Nemotron 3.5 Bolt E4B, il modello gratuito di Nvidia. Il post di @alex_verem che lo consiglia come “il download più intelligente della settimana” ha superato i 3.200 like e le 263.000 visualizzazioni al 16 novembre. Il post però sbaglia un dato: ecco cosa serve davvero e come provarlo in pochi minuti.
Cos’è Nemotron 3.5 Bolt e perché se ne parla
È un modello linguistico “piccolo” che Nvidia ha pubblicato a ottobre su Hugging Face, costruito partendo da Gemma 4 E4B di Google. In pratica è un chatbot come quelli che trovi nella nostra guida all’intelligenza artificiale, ma invece di girare sui server di un’azienda gira sul tuo computer.
I punti che contano per chi lo vuole usare:
- è gratis e la licenza (OpenMDW 1.1) permette anche l’uso commerciale;
- parla italiano: è tra le lingue su cui Nvidia lo ha addestrato dopo la base, insieme a inglese, francese, tedesco, spagnolo, giapponese e cinese;
- lavora solo con il testo (niente foto né voce), ricorda conversazioni lunghe (fino a 64.000 token) e ha una modalità “ragionamento” da attivare per le domande più difficili;
- ha 8 miliardi di parametri, di cui 4 “effettivi”: per questo sta su un portatile normale.
La pagina ufficiale conta oltre 150.000 download, e la versione per i programmi più diffusi (GGUF di Unsloth) circa 660.000 al 16 novembre.
Quanto pesa davvero (non 4 GB)
Il post parla di un file da 4 GB, come dice anche il nome. La versione che Nvidia consiglia per l’uso sul PC (Q4_K_M in formato GGUF) però pesa 6,18 GB. Nelle risposte al post qualcuno fa notare anche un’altra cosa vera: un modello occupa in memoria più del suo file, perché serve spazio per la conversazione.
Nvidia non indica una RAM minima. Una regola prudente: conta almeno la dimensione del file più qualche GB di margine, quindi un portatile con 16 GB di RAM è la scelta tranquilla; con 8 GB può partire ma rischia di essere lento o di bloccarsi con altri programmi aperti. Se hai una scheda video Nvidia con abbastanza memoria va più veloce, ma non è obbligatoria. Per modelli più grandi da far girare in casa leggi quale scheda video serve per Qwen 3.8 27B in locale.
Come installarlo sul PC
Il modo più semplice, senza scrivere comandi:
- scarica e installa LM Studio (gratis, per Windows, Mac e Linux) dal sito ufficiale;
- nella ricerca dei modelli scrivi “Nemotron 3.5 Bolt E4B” (oppure apri la pagina del modello e scegli “Use this model” e poi LM Studio);
- scegli la versione Q4_K_M e scaricala;
- caricala nella chat e scrivi in italiano. Da qui puoi anche spegnere il Wi-Fi: funziona lo stesso.
Se usi già Ollama, basta un comando nel terminale:
ollama run hf.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB:Q4_K_M
Funziona anche con llama.cpp, Jan e gli altri programmi che leggono i file GGUF. Per chi ha un PC molto potente esiste il fratello maggiore da 74 miliardi di parametri, che però pesa 24 GB.
Per chi ha senso
Un’AI offline è utile se scrivi cose che non vuoi mandare a un’azienda (documenti di lavoro, dati personali), se viaggi spesso senza connessione o se vuoi semplicemente provare un chatbot senza account. Non aspettarti lo stesso livello dei servizi online più forti: per ricerche complesse o testi lunghi ChatGPT, Gemini e Claude restano avanti (vedi il nostro confronto Claude o ChatGPT e la classifica della migliore intelligenza artificiale). Se cerchi un’alternativa ai servizi che in Italia non trovi sugli store, c’è anche la nostra guida a DeepSeek in Italia.